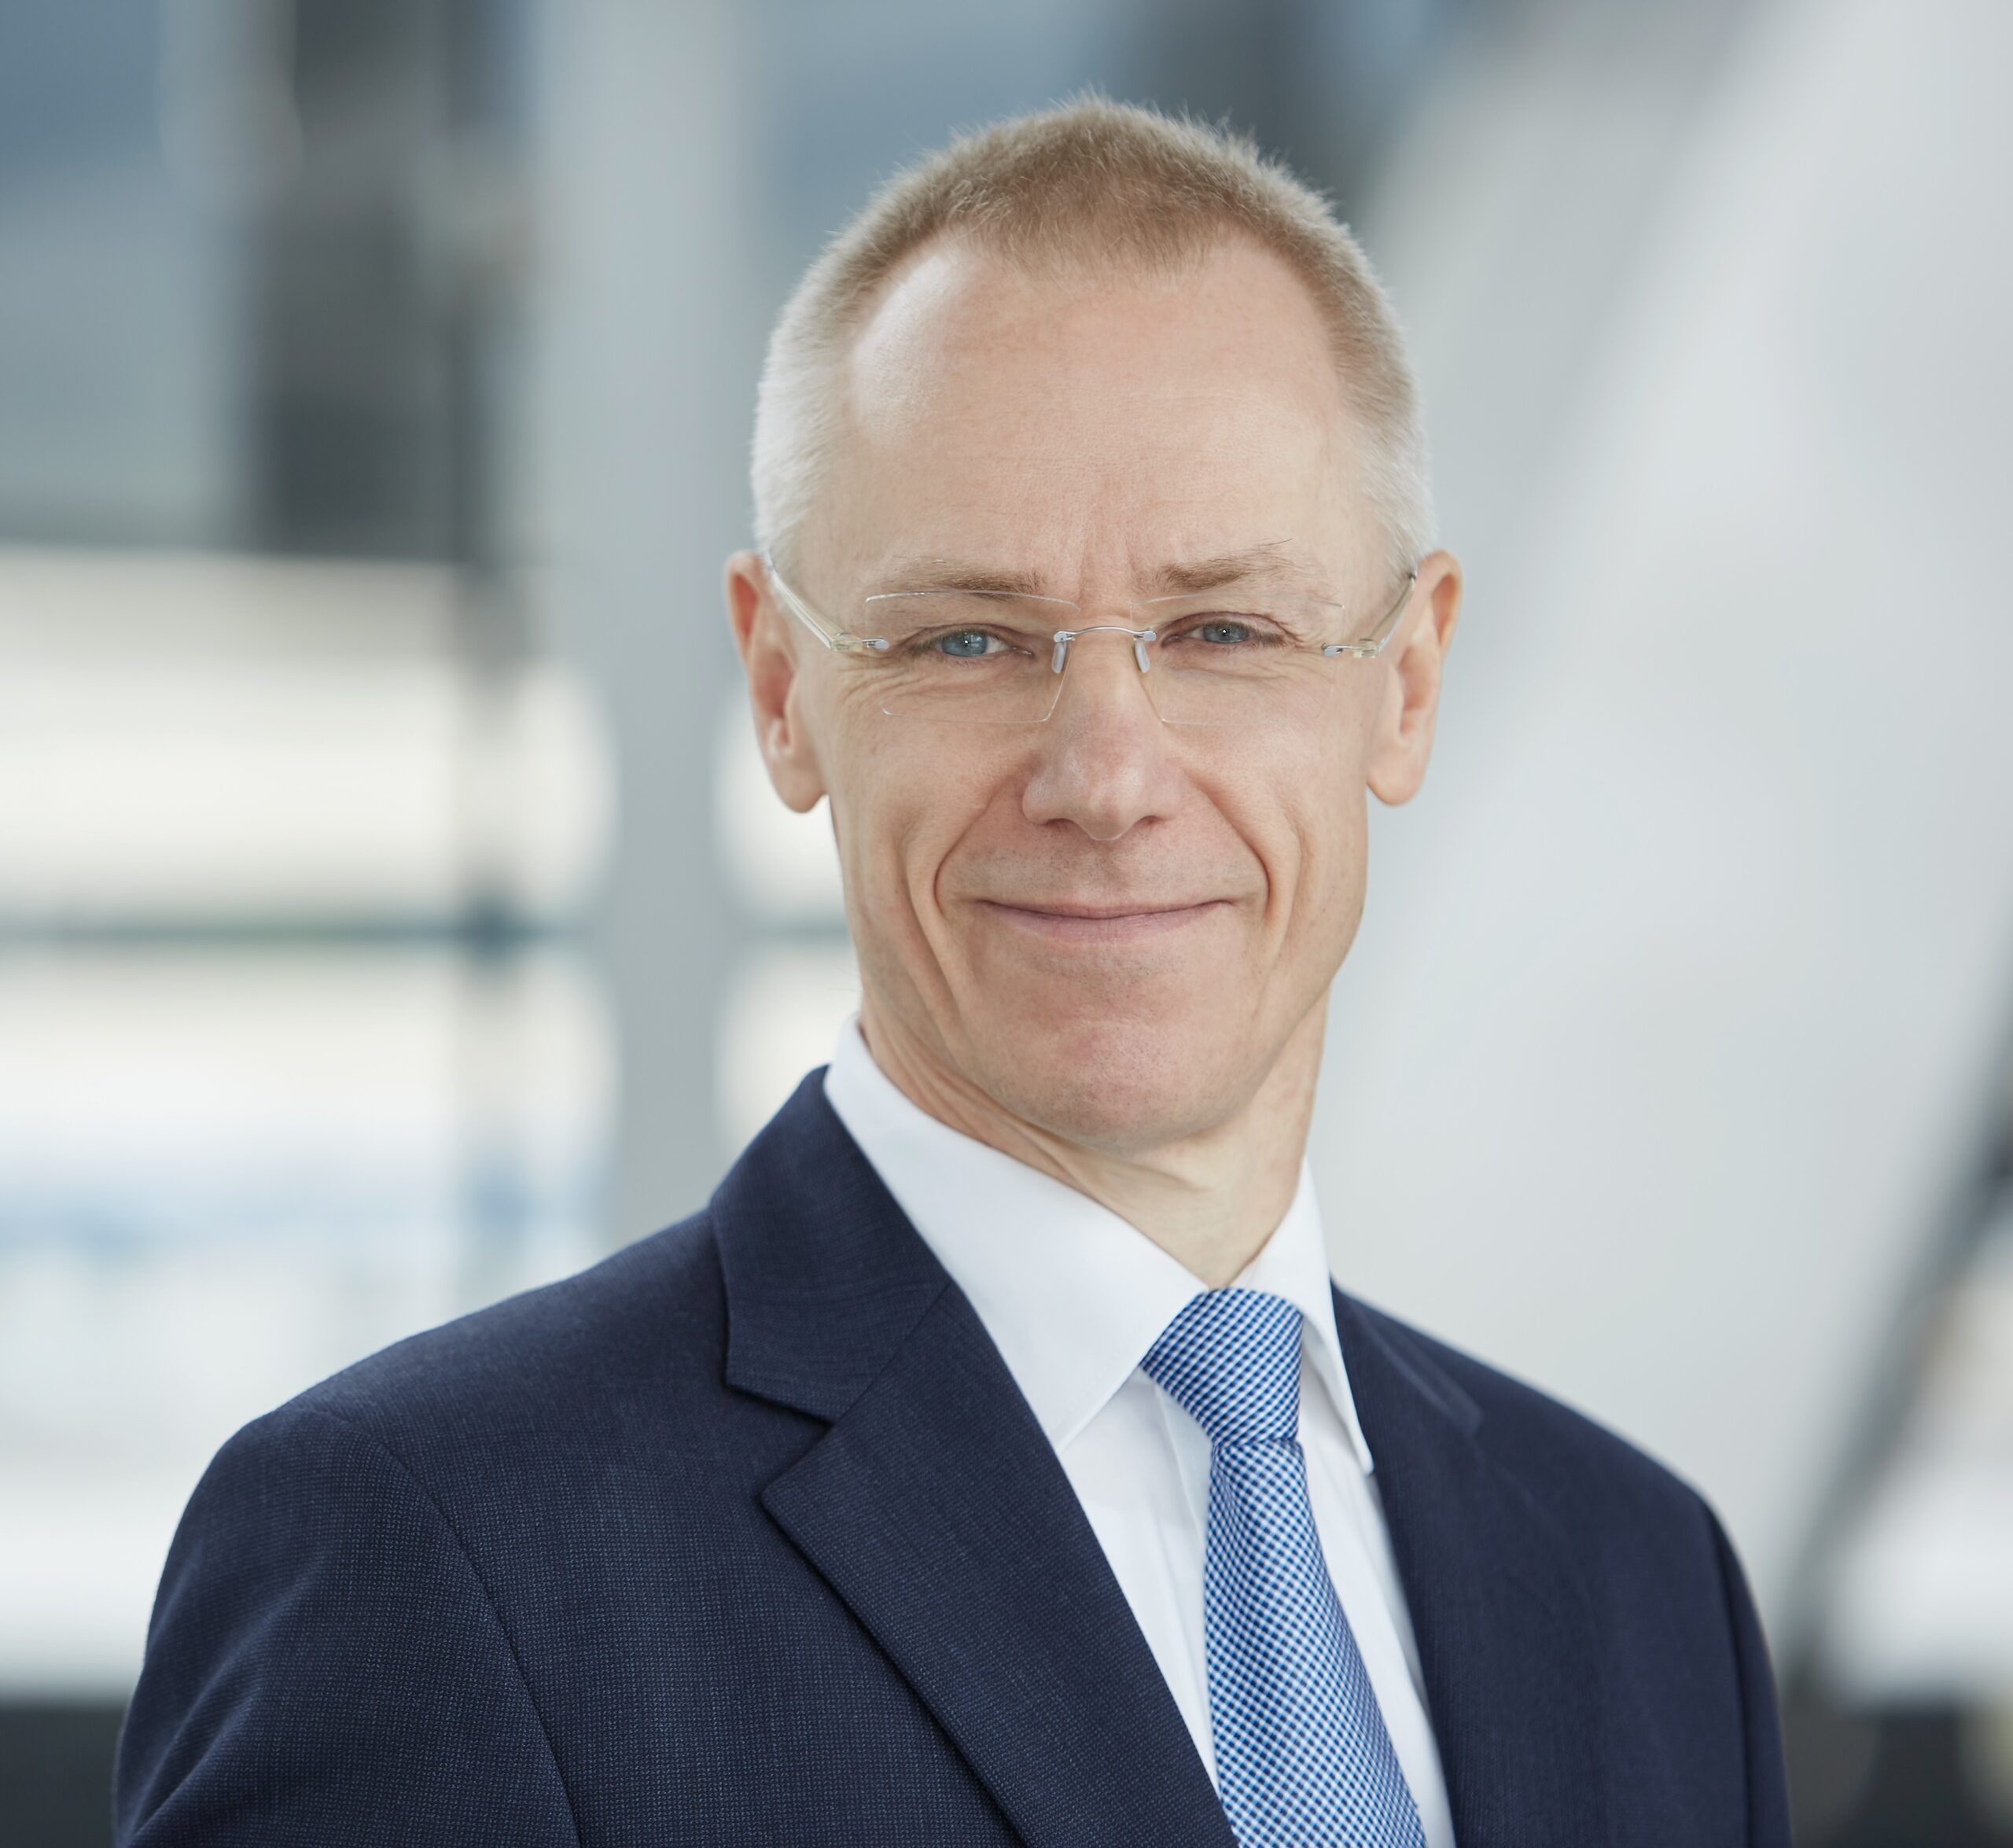
Dr. Andreas Vieweg, Spezialist für Prozessoptimierung in der Industrie | © Dr. Andreas Vieweg
Künstliche Intelligenz hält zunehmend Einzug in deutsche Unternehmen. Doch während die Investitionen in neue Anwendungen steigen, bleibt eine entscheidende Voraussetzung häufig unbeachtet: die Qualität der betrieblichen Daten. Veraltete Stammdaten, unvollständige Stücklisten und widersprüchliche Informationen können dazu führen, dass KI-Systeme falsche Prognosen erstellen und fehlerhafte Entscheidungen vorbereiten. Davor warnt der Aachener Industrie- und Prozessexperte Andreas Vieweg.
Laut einer Bitkom-Erhebung vom September 2026 setzen bereits 57 Prozent der deutschen Unternehmen mit mindestens 20 Beschäftigten künstliche Intelligenz ein. Ein Jahr zuvor waren es 36 Prozent, 2024 erst 20 Prozent. Die zunehmende Verbreitung bedeutet allerdings nicht, dass die eingesetzten Systeme ihr Potenzial bereits ausschöpfen.
Datenqualität wird zum Engpass
Nach Angaben von Bitkom sehen 59 Prozent der Unternehmen, die KI einsetzen, deren Potenzial bislang überhaupt nicht ausgeschöpft. Weitere 28 Prozent nutzen die Möglichkeiten nach eigener Einschätzung nur in geringem Umfang.
Eine wesentliche Ursache liegt in der betrieblichen Datenbasis. Das Statistische Bundesamt ermittelte für 2025, dass 44 Prozent jener Unternehmen, die einen KI-Einsatz erwogen, aber nicht umgesetzt hatten, Schwierigkeiten mit der Verfügbarkeit oder Qualität der benötigten Daten als Hindernis nannten.
„Viele Unternehmen kaufen gerade KI-Lizenzen, starten Pilotprojekte und lassen sich Chatbots und Agenten vorführen. Kaum jemand fragt vorher, in welchem Zustand die eigenen Daten sind“, kritisiert Vieweg.
Das Problem betrifft insbesondere Industrieunternehmen, deren Daten über Jahre in unterschiedlichen Systemen gewachsen sind. Informationen aus ERP-Systemen, Fertigungssteuerung, Kundenmanagement und Qualitätssicherung stimmen häufig nicht vollständig überein.
Eine internationale Untersuchung von Precisely und der Drexel University unterstreicht die Herausforderung: Nur zwölf Prozent der befragten Daten- und Analysefachleute bewerteten ihre Daten als ausreichend hochwertig und zugänglich für KI-Anwendungen.
Fehlerhafte Stammdaten beeinflussen Entscheidungen
In der industriellen Praxis können bereits kleine Datenfehler erhebliche Auswirkungen haben. Veraltete Wiederbeschaffungszeiten, nicht aktualisierte Stücklisten oder falsche Vorgabezeiten in Arbeitsplänen beeinflussen beispielsweise die Materialdisposition und Produktionsplanung.
Hinzu kommen doppelte Kunden- und Lieferantendatensätze sowie parallel geführte Excel-Listen, die von den offiziellen Unternehmenssystemen abweichen.
Solange erfahrene Beschäftigte solche Fehler erkennen und durch eigenes Wissen ausgleichen, bleiben die Auswirkungen teilweise begrenzt. Bei automatisierten Entscheidungen entfällt diese informelle Kontrolle jedoch zunehmend.
„Ein erfahrener Disponent weiß, dass die Wiederbeschaffungszeit im System seit Jahren nicht stimmt, und rechnet sie im Kopf um“, erklärt Vieweg. „Eine KI weiß das nicht. Sie nimmt den Wert ernst, plant damit, bestellt damit und begründet ihr Ergebnis auch noch überzeugend.“
Besonders problematisch ist dabei, dass KI-generierte Ergebnisse trotz fehlerhafter Ausgangsdaten plausibel erscheinen können.
Datenprobleme verursachen hohe Kosten
Die wirtschaftlichen Folgen unzureichender Datenqualität zeigen mehrere internationale Untersuchungen.
Laut einer Studie von Fivetran und Vanson Bourne berichteten 42 Prozent von 550 Befragten aus größeren Unternehmen über sogenannte Halluzinationen ihrer KI-Anwendungen. Die Studie beziffert die durchschnittlichen Umsatzverluste durch Fehlentscheidungen auf Basis ungenauer oder minderwertiger Daten auf sechs Prozent des weltweiten Jahresumsatzes der befragten Unternehmen.
Auch die Datenaufbereitung bindet erhebliche Ressourcen. Nach dieser Erhebung verbringen Datenspezialist:innen rund zwei Drittel ihrer Arbeitszeit damit, Daten vorzubereiten, anstatt KI-Modelle zu entwickeln.
Eine weitere Fivetran-Studie vom November 2026 zeigt, dass 39 Prozent der befragten Unternehmen mindestens ein Viertel ihres KI-Budgets für die Behebung von Datenproblemen einsetzen.
Solche Ergebnisse verdeutlichen die wirtschaftliche Bedeutung einer verlässlichen Datenbasis. Allerdings beruhen die genannten Kostenangaben auf Befragungen und lassen sich nicht ohne Weiteres auf jedes Unternehmen übertragen.
Datenmanagement vor Automatisierung
Vieweg empfiehlt Industrieunternehmen, vor der Einführung neuer KI-Anwendungen zunächst die Qualität ihrer betrieblichen Daten systematisch zu überprüfen.
Am Anfang sollte eine Bestandsaufnahme stehen: Welche Daten werden für den geplanten Anwendungsfall benötigt, wo werden sie gespeichert und wie aktuell sind sie?
Anschließend müssten klare Verantwortlichkeiten für einzelne Datenbereiche festgelegt und fehlerhafte Stammdaten bereinigt werden. Entscheidend sei außerdem, die zugrunde liegenden Geschäftsprozesse zu verbessern, damit nicht laufend neue Datenfehler entstehen.
Parallel geführte Excel-Listen sollten möglichst in die maßgeblichen Unternehmenssysteme integriert werden. Erste KI-Anwendungen empfiehlt Vieweg in klar abgegrenzten Pilotprojekten zu testen und dabei Kennzahlen wie Datenvollständigkeit, Aktualität und Dublettenquote zu erfassen.
Die Datenpflege müsse schließlich als dauerhafte Aufgabe im Unternehmen verankert werden.
„Wer heute seine Stammdaten in Ordnung bringt, hat morgen eine KI, auf die er sich verlassen kann. Wer diesen Schritt überspringt, automatisiert nur das Datenchaos“, fasst Vieweg zusammen.
EU-KI-Verordnung erhöht Anforderungen
Zusätzliche Bedeutung erhält das Thema durch die europäische KI-Verordnung. Artikel 10 des AI Act stellt für bestimmte Hochrisiko-KI-Systeme Anforderungen an die Qualität von Trainings-, Validierungs- und Testdaten. Diese müssen unter anderem relevant, ausreichend repräsentativ und so weit wie möglich fehlerfrei und vollständig sein.
Die Vorgaben betreffen nicht sämtliche KI-Anwendungen gleichermaßen. Unabhängig von der jeweiligen rechtlichen Einstufung bleibt eine verlässliche Datenbasis jedoch eine wesentliche Voraussetzung für den betrieblichen Einsatz.
Auch Bitkom-Präsident Ralf Wintergerst verweist auf die besonderen Anforderungen autonom handelnder KI-Systeme: „Ein Agent, der eigenständig handelt, braucht verlässliche Daten, verbundene Systeme und Regeln, was er darf und was er zu lassen hat.“
Für Industrieunternehmen ergibt sich daraus eine klare Priorität: Bevor KI-Systeme eigenständig Produktionsabläufe planen, Materialbestellungen auslösen oder Prognosen erstellen, müssen die zugrunde liegenden Informationen ausreichend zuverlässig sein. Andernfalls besteht die Gefahr, bestehende Fehler nicht zu beseitigen, sondern durch Automatisierung zu vervielfachen.